Korea Deep Learning thay đổi cuộc chơi bồi thường bảo hiểm với DEEP Agent
Korea Deep Learning tiến quân vào thị trường bảo hiểm với giải pháp DEEP Agent, giúp tự động hóa quy trình và giảm 87% việc kiểm tra thủ công.
| NBNTV = Phóng viên Jeong Dong-jin | Korea Deep Learning đang tiến quân vào thị trường bảo hiểm, hứa hẹn thay đổi cục diện của việc yêu cầu bồi thường bảo hiểm.
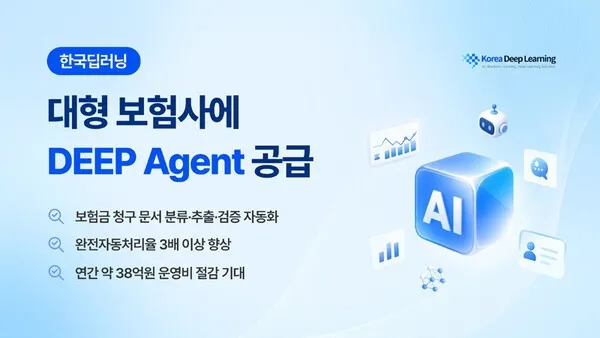
Theo Korea Deep Learning vào ngày 11, công ty sẽ cung cấp giải pháp tự động hóa tài liệu DEEP Agent cho một công ty bảo hiểm lớn trong nước.
Công ty bảo hiểm này đã quyết định áp dụng DEEP Agent để không chỉ dừng lại ở việc nhận diện tài liệu đơn thuần, mà còn tự động hóa việc cấu trúc hồ sơ theo từng vụ yêu cầu, trích xuất thông tin, xác minh kết quả và phân loại các tài liệu ngoại lệ.
Trước đây, các loại giấy tờ chứng minh đa dạng như đơn yêu cầu bồi thường, bảng kê chi tiết chi phí điều trị, hóa đơn, chứng minh thư, bản sao sổ tài khoản, v.v., sẽ được nhận diện bước đầu bằng OCR. Sau đó, đối với những tài liệu có kết quả không chắc chắn hoặc thiếu hạng mục, nhân sự kiểm tra bên ngoài phải đối chiếu lại với văn bản gốc.
Khi lượng yêu cầu bồi thường tăng lên, công ty phải huy động thêm đội ngũ kiểm tra bên ngoài với quy mô hàng chục người, và chi phí cho mỗi tờ tài liệu rơi vào khoảng 2.500~3.000 won. Ngay cả sau khi áp dụng AI, do các bảng biểu phức tạp, hình ảnh chất lượng thấp và các định dạng khác nhau vẫn cần phải kiểm tra lại, nên cấu trúc chi phí nhân lực và vận hành vẫn tăng cùng với lượng tài liệu.
DEEP Agent cấu trúc nhiều loại giấy tờ trong một vụ yêu cầu bồi thường thành một đơn vị công việc duy nhất. Nó gom các tài liệu đã tiếp nhận theo từng vụ yêu cầu để kiểm tra xem đã nộp đầy đủ các giấy tờ cần thiết chưa, và chuyển các vụ bình thường đã xác nhận đầy đủ giấy tờ và thông tin sang giai đoạn thẩm định tiếp theo.
Vì các trường hợp thiếu giấy tờ, thông tin không khớp hoặc kết quả có độ tin cậy thấp cần xác minh văn bản gốc được tách riêng thành các đối tượng ngoại lệ, nên người phụ trách có thể tập trung vào các vụ yêu cầu cần yêu cầu bổ sung hoặc cần phán đoán thêm.
Trong quá trình thực hiện dự án này, Korea Deep Learning đã nâng cao công cụ xử lý cốt lõi của DEEP Agent, mở rộng phạm vi xử lý từ các tài liệu định dạng dựa trên chữ in sang cả các tài liệu khó như chữ viết tay, bảng biểu phức tạp, hình ảnh chất lượng thấp và chi tiết chi phí điều trị kéo dài trên nhiều trang.
Đầu tiên, OCR đã được tăng cường hiệu suất để nhận diện ổn định các thông tin chính như con số và số tiền ngay cả trong các hóa đơn hoặc tài liệu điều trị có ảnh bị nghiêng hoặc chất lượng thấp. Ngoài ra, Parser đã khôi phục chính xác cấu trúc và thứ tự đọc của các bảng biểu phức tạp, các ô bị gộp và chi tiết chi phí điều trị kéo dài qua nhiều trang, giúp giảm thiểu lỗi kết nối sai giữa hạng mục và số tiền.
Thông tin được trích xuất sau đó sẽ được tinh lọc một lần nữa thông qua VLM và công cụ xác minh. VLM chuyên dụng cho tài liệu sẽ phân tích toàn bộ bố cục và ngữ cảnh để cấu trúc hóa các hạng mục có cùng ý nghĩa phù hợp với tiêu chuẩn nghiệp vụ ngay cả khi định dạng thay đổi.
Ngoài ra, công cụ xác minh sẽ đối chiếu các giá trị được ghi trên nhiều tài liệu khác nhau như thông tin người yêu cầu, người được bảo hiểm, thông tin tài khoản, thời gian điều trị, số tiền yêu cầu, v.v., để tự động kiểm tra việc thiếu giấy tờ bắt buộc hoặc sự không nhất quán về thông tin.
Các loại lỗi lặp đi lặp lại và mô hình kiểm tra lại cũng được phản ánh vào việc cải tiến công cụ. Không chỉ dừng lại ở việc nâng cao tỷ lệ nhận diện ký tự trung bình, công ty tập trung vào việc nâng cao tính ổn định trong xử lý các tài liệu ngoại lệ vốn làm gián đoạn quá trình tự động hóa, chẳng hạn như hình ảnh chất lượng kém, cấu trúc phức tạp và xung đột giá trị giữa các tài liệu.
Kết quả kiểm chứng trước khi áp dụng sử dụng các tài liệu yêu cầu bồi thường bảo hiểm cho thấy, số lượng tài liệu cần kiểm tra lại đã giảm 87% so với trước đây, và tỷ lệ xử lý hoàn toàn tự động — bao gồm phân loại, trích xuất, cấu trúc hóa và xác minh mà không cần sự can thiệp của con người — đã tăng từ 28% lên 91%.
Korea Deep Learning có kế hoạch mở rộng phạm vi áp dụng công cụ DEEP Agent nâng cao vào các ngành công nghiệp xử lý lượng lớn tài liệu phi cấu trúc như tài chính, bảo hiểm, công cộng và sản xuất trong tương lai.
Gim Ji-hyeon, đại diện của Korea Deep Learning, cho biết: "Sự thành bại của tự động hóa tài liệu doanh nghiệp không nằm ở việc đọc tốt các tài liệu thông thường như thế nào, mà nằm ở việc giảm thiểu được bao nhiêu vấn đề con người phải can thiệp lại vào toàn bộ công việc do một số tài liệu khó khăn gây ra. Chúng tôi sẽ liên tục tăng cường công cụ xử lý cốt lõi của DEEP Agent để mang lại sự tự động hóa tài liệu mà doanh nghiệp có thể cảm nhận rõ rệt."
Bình luận 0