Korea Deep Learning、保険金請求を自動化する「DEEP Agent」を提供開始
Korea Deep Learningが文書自動化ソリューション「DEEP Agent」で保険市場へ進出。書類の構成から情報抽出、検証までを自動化し、保険金請求業務の効率を劇的に向上させます。
| NBNTV=チョン・ドンジン記者 |
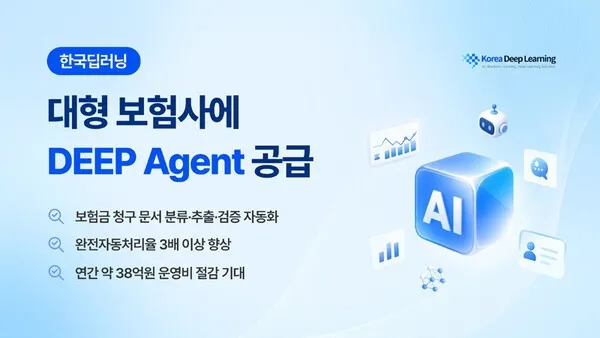
Korea Deep Learningが保険市場へ進出し、保険金請求のあり方を一変させようとしている。
11日、Korea Deep Learningによると、国内の大手保険会社に文書自動化ソリューション「DEEP Agent」を供給する。
該当の保険会社は、単なる文書認識を超え、請求案件ごとの書類構成や情報抽出、結果の検証、例外文書の選別までを自動化するために、DEEP Agentの導入を決定した。
従来は、保険金請求書や診療費明細書、領収書、身分証、通帳のコピーなど、多様な証明書類をOCRで一次認識した後、結果が不確実であったり項目が漏れていたりする書類を、外部の検収人員が原本と照らし合わせて再確認する方式で処理してきた。
請求量が増えれば、数十人規模の外部検収人員を追加投入する必要があり、書類1枚あたり約2,500〜3,000ウォンのコストが発生していた。AI導入後も、複雑な表や低画質の画像、異なる様式による再検収が残るため、書類量とともに人員や運営費が増加する構造となっていた。
DEEP Agentは、一つの保険金請求案件に含まれる複数の書類を一つの業務単位として構成する。受付された書類を請求案件ごとにまとめ、必須書類の提出有無を確認し、書類と情報がすべて確認された正常な案件は後続の審査段階へと転送する。
書類の漏れ、情報の不一致、原本確認が必要な低信頼の結果は、別途「例外対象」として分離するため、担当者は補完要請や追加判断が必要な請求案件だけに集中することができる。
Korea Deep Learningは今回の事業を進めるにあたり、DEEP Agentの核心となる処理エンジンを高度化し、印刷体中心の定型文書を超えて、筆記体や複雑な表、低画質画像、複数ページにわたる診療費明細など、高難度の文書まで処理範囲を拡大した。
まずOCRは、写真が傾いていたり画質が低かったりする領収書や診療書類でも、数字や金額などの主要情報を安定的に認識できるよう性能を強化した。また、Parserは複雑な表や結合セル、複数ページにわたって続く診療費明細の構造と読み取り順序を正確に復元し、項目と金額が誤って連結されるエラーを減少させた。
抽出された情報は、その後VLMと検証エンジンを経て、さらにもう一度精製される。文書特化型VLMは、全体のレイアウトと文脈を共に分析し、様式が異なっても同じ意味を持つ項目を業務基準に合わせて構造化する。
さらに検証エンジンは、請求人・被保険者の情報、口座情報、診療期間、請求金額など、複数の書類に記載された値を相互に照合し、必須書類の漏れや情報の不一致の有無を自動点検する。
繰り返し発生したエラーの類型や再検収のパターンも、エンジンの改善に反映させた。平均文字認識率を高めるにとどまらず、低品質な画像や複雑な構造、書類間の値の衝突など、実際の自動化を中断させる例外文書の処理安定性を高めることに集中した。
保険金請求書類を活用した導入前の事前検証結果によると、再検収対象となる書類は従来比で87%減少し、人の介入なしに分類・抽出・構造化・検証まで完了する「完全自動処理率」は28%から91%へと上昇した。
Korea Deep Learningは今後、金融・保険・公共・製造など、大量の非定型文書を処理する産業を中心に、高度化したDEEP Agentエンジンの適用範囲を拡大していく計画だ。
Korea Deep Learningのキム・ジヒョン代表は、「企業における文書自動化の成否は、一般的な文書をいかに上手く読むかではなく、一部の厄介な文書のために人が全体の業務に再び介入してしまう問題を、いかに減らせるかにかかっている」とし、「企業が実感できる文書自動化を実現するため、DEEP Agentの核心処理エンジンを継続的に強化していく」と述べた。
コメント 0